
Dos horas separaron la llegada del informe Tailworm al equipo de seguridad de Tailscale, en la mañana del sábado 24 de octubre de 2026, de su publicación completa en internet. Tres días después, la versión 1.104.4 del cliente corrige los fallos de Tailscale SSH que, en el laboratorio de su autora, convertían un solo equipo comprometido de la tailnet en root sobre cada servidor al que ese equipo tenía permiso para conectarse.
Cómo un reenvío con ssh -L terminaba en un socket de root
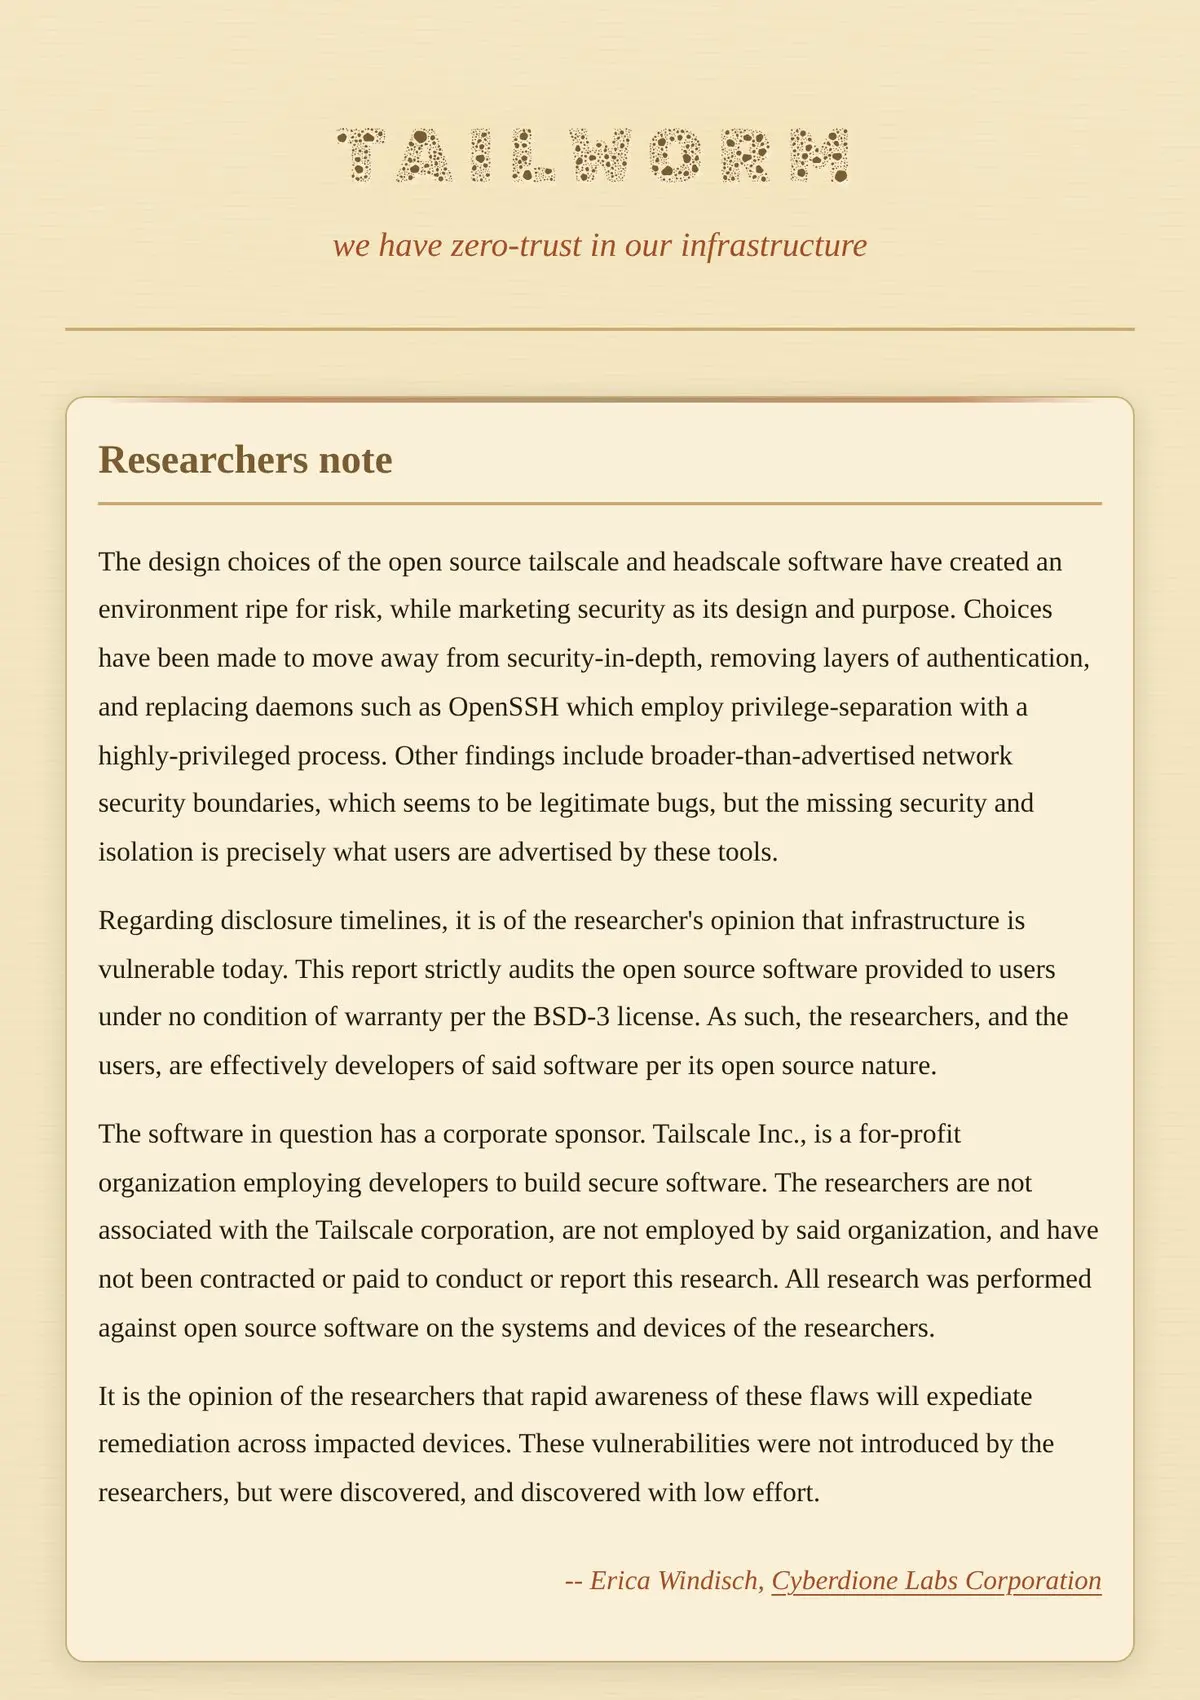
Tailscale SSH es el servidor SSH integrado en tailscaled, el demonio del cliente, que en Linux se ejecuta como root. No pide contraseña ni clave privada. La red ya ha identificado al equipo con su clave de nodo, y la política de la tailnet decide qué equipo entra en qué máquina y con qué usuario local. El informe Tailworm de Erica Windisch, de Cyberdione Labs, parte de ese modelo para explicar sus tres primeros hallazgos. La nota con la que abre el documento, que International Cyber Digest difundió en X el 25 de octubre, resume su postura sobre el diseño del producto.
El problema estaba en lo que ocurre después de entrar. El boletín TS-2026-014 explica que tailscaled comprobaba las rutas de los sockets Unix de forma léxica y luego ejecutaba la operación como root. Con el reenvío local (ssh -L), una sesión normal podía pedir al demonio que se conectara a un socket reservado a root. Con el reenvío remoto (ssh -R), podía borrar un socket de root y ocupar su ruta. Y una condición de carrera anulaba la lista de rutas permitidas, porque el kernel vuelve a resolver la ruta después de la comprobación.
En las pruebas de Windisch, hechas entre el 22 y el 24 de octubre contra Tailscale 1.104.2 y headscale 0.29.5, el reenvío hacia el socket de Docker devolvió uid=0 y el contenido del fichero shadow de contraseñas sin sudo ni pertenencia al grupo docker. El bucle de renombrados que gana la carrera llegó a unos 170.000 cambios de ruta por segundo desde una sesión sin privilegios. Por esa vía capturó una authkey que viajaba hacia la API local de tailscaled y, en una máquina virtual de laboratorio, unió a la tailnet un nodo ajeno con la identidad de la víctima, en la configuración por defecto sin Tailnet Lock.
El nombre viene de la propagación. Con reglas SSH amplias, un ataque automatizado saltó de máquina en máquina a menos de un segundo por salto, sin contraseñas ni claves robadas, hasta cubrir todos los equipos que la política permitía. El informe atribuye el freno de la cadena a un único control, las reglas SSH concedidas par a par entre equipos concretos.
Tailscale rechaza la etiqueta de gusano. En su análisis de hallazgos y correcciones, firmado por Mike Shaver, vicepresidente de ingeniería, la compañía lo describe como «lateral movement limited to connections allowed by a tailnet policy file» (movimiento lateral limitado a las conexiones que permite la política de la tailnet) y recuerda que hace falta un punto de apoyo previo en un equipo autorizado.
Ese punto de apoyo llega por las vías de siempre. El propio informe cita una aplicación web vulnerable, un paquete malicioso de npm o PyPI como el que vimos con la versión troyanizada de LiteLLM, un implante de phishing o unas credenciales robadas. La red mallada no crea la intrusión. En este escenario, la extendía a velocidad de máquina.
Los cuatro boletines que cierra Tailscale 1.104.4
Tailscale publicó el 26 de octubre cuatro boletines, del TS-2026-014 al TS-2026-017, y la versión 1.104.4 quedó etiquetada el 27 de octubre, según el registro de respuesta del propio informe. El paquete ya figura en el repositorio estable de Tailscale. Ningún boletín lleva identificador CVE ni puntuación CVSS.
Dato | Detalle |
|---|---|
Producto | Tailscale (tailscaled y su servidor Tailscale SSH) y el servidor de control headscale |
Boletines | TS-2026-014 (reenvío de sockets Unix), TS-2026-015 (agotamiento de memoria), TS-2026-016 (Serve con backends Unix) y TS-2026-017 (Serve sobre HTTP/2) |
CVE | Tailscale no ha publicado identificadores CVE en sus boletines a 28 de octubre de 2026 |
Gravedad | Tailscale no publica CVSS. El informe Tailworm califica de gravedad alta 6 de sus 11 hallazgos |
Versiones afectadas | Tailscale anteriores a 1.104.4 (probada la 1.104.2) y headscale 0.29.5 |
Versión corregida | Tailscale 1.104.4, etiquetada el 27 de octubre de 2026 |
Requisito del atacante | Control previo de un equipo de la tailnet y una regla SSH que permita el reenvío |
Explotación activa | No consta. Ni Tailscale ni el informe hablan de ataques reales y no figura en el catálogo KEV de CISA |
Mitigación temporal | Variable TS_SSH_DISABLE_FORWARDING=1 en el entorno de tailscaled |
TS-2026-015 abre otro frente. Una sesión SSH autorizada podía enviar mensajes de cambio de tamaño de ventana y variables de entorno sin límite hasta agotar la memoria del equipo. El sistema acababa matando tailscaled, y con él todas las conexiones Tailscale del nodo.
TS-2026-016 afecta a tailscale serve. Los reenvíos TCP hacia sockets Unix no tenían la protección que sí tenía la ruta HTTP y conectaban como root, lo que abría la API local del nodo a pares remotos. La comprobación de enlaces simbólicos, por su parte, solo se hacía al recargar la configuración. TS-2026-017 es una condición de carrera en HTTP/2 que solo aparece cuando un nodo sirve con TLS dos montajes con requisitos distintos. Las cabeceras Tailscale-App-Capabilities de uno podían acabar en las peticiones del otro.
La corrección de fondo cambia quién ejecuta la operación. Desde la 1.104.4, tailscaled hace el reenvío de sockets en nombre del usuario autenticado y deja de hacerlo como root. Es el mismo criterio que aplicó Dropbear en su versión 2025.89 tras CVE-2025-14282, el precedente que cita Windisch.
Esta pieza de Tailscale SSH ya había fallado antes. El 3 de junio, el boletín TS-2026-004 corrigió en la versión 1.98.9 un fallo del mismo reenvío, en el que un enlace simbólico en una ruta del usuario apuntaba a /var/run/docker.sock y daba acceso al socket de Docker. Aquella corrección añadió la resolución de enlaces a la comprobación léxica. Tailworm demuestra que revisar la ruta antes de usarla no sirve de mucho cuando quien la usa es root.
Tailscale lleva 17 boletines publicados en 2026, frente a 8 en todo 2025. El anterior a esta tanda, el TS-2026-013 del 21 de octubre, actualizó Go a la versión 1.27.3 en Tailscale 1.104.2 para desconfiar de los intermedios comprometidos de eMudhra, el caso que contamos con la retirada de la raíz de eMudhra en Chrome.
Dos horas de margen y una divulgación que dividió al sector
La cronología que da Tailscale arranca el viernes 23 de octubre, cuando empezaron a circular en redes sociales dudas sobre Tailscale SSH y sus equipos abrieron una investigación con especialistas externos. El informe llegó a su buzón de seguridad la mañana del sábado 24 y se publicó dos horas después. Varios medios fecharon la publicación el 25 de octubre, una diferencia que encaja con los husos horarios. El lunes 26, la compañía colgó una actualización de la investigación en la que reconocía los fallos.
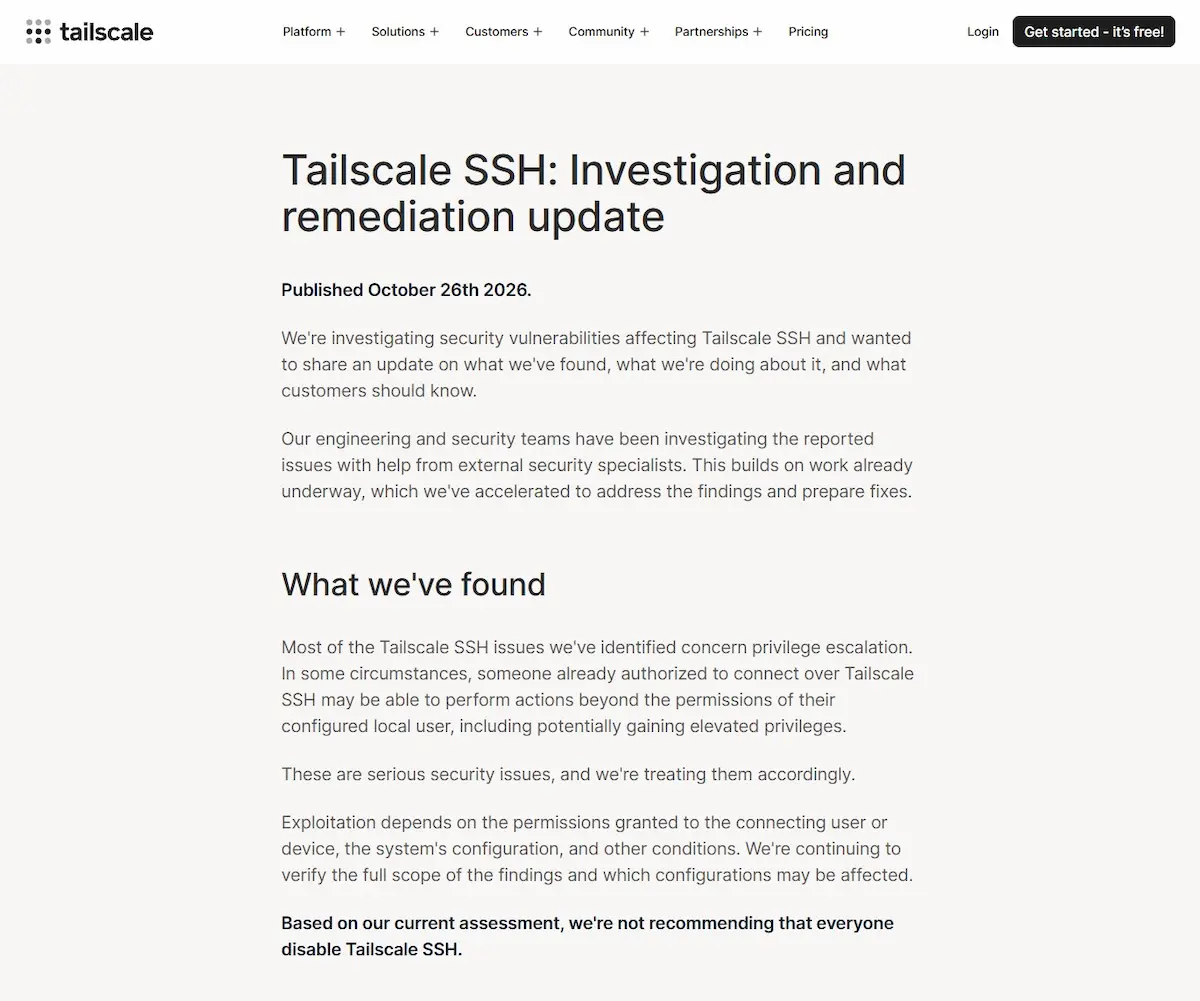
The Hacker News difundió en X el 27 de octubre esa página de Tailscale, que admite que la mayoría de los problemas son escaladas de privilegios y dice «These are serious security issues, and we're treating them accordingly.» (son problemas de seguridad serios y los tratamos como tales). En el mismo texto, la compañía pedía no desactivar Tailscale SSH de forma general mientras llegaba el parche.
Windisch defiende la publicación inmediata en la nota que abre el informe. Sostiene que la infraestructura ya es vulnerable hoy y que «rapid awareness of these flaws will expediate remediation across impacted devices» (conocer rápido estos fallos acelerará su corrección en los equipos afectados). La misma nota acusa a Tailscale y headscale de haber renunciado a la defensa en profundidad al sustituir a OpenSSH, que separa privilegios, por un proceso con todos los privilegios.
Esa nota alimentó un debate que se repartió entre quienes ponían el foco en los fallos y quienes lo ponían en la forma. El divulgador NetworkChuck pidió ese mismo día «stop publishing vulns before they are disclosed to the vendor» (dejar de publicar fallos antes de comunicarlos al fabricante), un mensaje que superó los 3.600 me gusta.
Dude, can we please stop publishing vulns before they are disclosed to the vendor!?!?!?!??! https://t.co/rZgDPRoZTQ
— NetworkChuck (@NetworkChuck) October 25, 2026
Shaver contestó en su respuesta en Reddit que la mayoría de los fallos afectan a lo que pasa después de autorizar la conexión, y que «it isn’t the same as an unauthenticated attacker being able to connect to arbitrary machines» (no equivale a que un atacante sin autenticar pueda conectarse a cualquier máquina).
En nuestra opinión, dos horas de aviso no tienen justificación para unos fallos sin explotación conocida que exigen acceso previo a la red. El contenido técnico, en cambio, se sostiene. Tailscale ha reproducido y corregido en tres días los fallos de reenvío con el mismo diagnóstico que el informe. Tampoco conviene exagerar el alcance. Esto no se parece a los zero-days de Ivanti Connect Secure, que daban root sin autenticar desde internet. Aquí el atacante ya tiene que estar dentro, y el daño depende de lo amplias que sean las reglas SSH.
Tailworm sí toca el argumento central del enfoque zero trust, que da por hecho que cualquier equipo puede estar comprometido. Una regla SSH que deja a toda una etiqueta entrar en toda una flota contradice ese principio.
Qué revisar en una tailnet con Tailscale SSH activo
A 28 de octubre no hay un recuento público de nodos con Tailscale SSH activo, ni en España ni fuera, porque el servicio no se expone a internet como una VPN SSL tradicional. Cada organización tiene que hacer su propio inventario. La API de Tailscale devuelve la versión del cliente de cada dispositivo, y este bloque la lista junto al sistema operativo y prepara la mitigación temporal en un servidor Linux con systemd.
# Versión de cliente de cada dispositivo de la tailnet (requiere una clave de API)
curl -s -u "$TS_API_KEY:" "https://api.tailscale.com/api/v2/tailnet/-/devices" \
  | jq -r '.devices[] | [.hostname, .clientVersion, .os] | @tsv' | sort -k2

# Mitigación mientras no se actualiza un nodo: desactivar el reenvío de Tailscale SSH
sudo mkdir -p /etc/systemd/system/tailscaled.service.d
printf '[Service]\nEnvironment=TS_SSH_DISABLE_FORWARDING=1\n' \
  | sudo tee /etc/systemd/system/tailscaled.service.d/no-forwarding.conf
sudo systemctl daemon-reload && sudo systemctl restart tailscaled
El reinicio de tailscaled corta las conexiones Tailscale del nodo durante unos segundos, así que conviene hacerlo desde otra vía de acceso o en una ventana de mantenimiento.
- Actualiza a Tailscale 1.104.4 o posterior todos los nodos que ejecutan Tailscale SSH o Serve, empezando por los servidores con Docker, kubelet o servicios que escuchan en sockets Unix de root.
- En los nodos que no puedas actualizar hoy, aplica TS_SSH_DISABLE_FORWARDING=1 como en el bloque anterior. El boletín TS-2026-014 indica que así se desactiva el reenvío sin apagar Tailscale SSH.
- Revisa la sección ssh de la política de la tailnet y sustituye las reglas que abren el acceso a grupos o etiquetas enteras por reglas entre equipos concretos. Quita root como usuario de destino donde no haga falta.
- Activa el modo check en los accesos a sistemas sensibles, para que cada conexión exija volver a autenticarse con el proveedor de identidad.
- Revisa si algún socket de root en /run o /tmp ha cambiado de inodo o de propietario y si hay authkeys emitidas o usadas fuera de las ventanas de cambio.
- Si sospechas de un compromiso, borra el dispositivo desde la consola de administración, rota las authkeys y credenciales accesibles desde ese equipo y comunícalo a INCIBE-CERT si eres empresa o particular, o al CCN-CERT si eres del sector público. Windisch demostró que una copia del fichero de estado recrea la identidad del nodo en otro hardware, así que reinstalar el equipo no revoca nada.
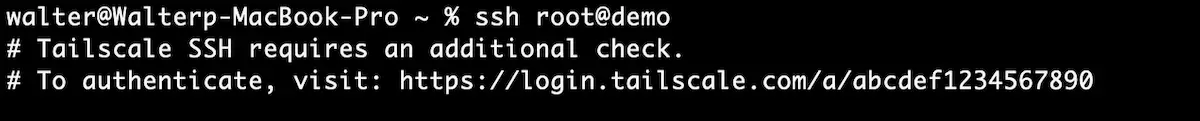
La documentación de Tailscale muestra cómo se ve el modo check desde la terminal. La conexión SSH como root se detiene y pide abrir un enlace de login.tailscale.com para volver a autenticarse antes de seguir. El periodo por defecto es de 12 horas y se puede reducir hasta exigirlo en cada conexión, a costa de complicar la vida a herramientas como Ansible.
El informe propone también auditar el ciclo de vida de los sockets en los directorios donde se permite el reenvío. En un servidor con Docker, estas reglas de auditd vigilan el socket de Docker y el de la API local de tailscaled, y la consulta posterior filtra los cambios que hace el propio tailscaled.
# /etc/audit/rules.d/tailscale-sockets.rules
-w /run/docker.sock -p wa -k ts-socket
-w /var/run/tailscale/tailscaled.sock -p wa -k ts-socket

# Cargar las reglas y buscar cambios hechos por tailscaled
sudo augenrules --load
sudo ausearch -k ts-socket -c tailscaled --interpret
Un evento en el que tailscaled borra o vuelve a crear el socket de Docker no tiene explicación legítima y merece revisarse dentro de una rutina de caza de amenazas en esos servidores.
Dudas habituales sobre la seguridad de Tailscale
¿Qué tan seguro es Tailscale?
Ninguno de los hallazgos de Tailworm afecta al cifrado del túnel WireGuard. Los fallos estaban en funciones añadidas encima, como el servidor SSH integrado y Serve, que tailscaled ejecuta como root. Tailscale ha publicado 17 boletines de seguridad en 2026, frente a 8 en 2025. La cifra no mide por sí sola la seguridad del producto, pero sí cuántas funciones conviene revisar antes de activarlas en producción.
¿Qué es Tailscale Funnel?
Funnel publica en internet un servicio local de un nodo a través de la infraestructura de Tailscale, mientras que Serve lo comparte solo dentro de la tailnet. El informe incluye dos hallazgos sobre Funnel y la variable TS_SERVE_ALLOW_ALL_INTERFACES. Tailscale responde que ambos funcionan según su diseño, porque saltarse la comprobación de Funnel exige ser administrador local y la variable es una opción que hay que activar a propósito.
¿Tailscale o WireGuard, cuál es mejor?
Tailscale usa WireGuard para cifrar el tráfico y añade un plano de control, identidades y funciones como Tailscale SSH. Ese valor añadido es la superficie que ha fallado ahora. Un despliegue de WireGuard a mano no tiene un demonio con privilegios que atienda sesiones SSH, pero obliga a repartir a mano las claves públicas de cada equipo y a mantener las reglas por tu cuenta.
headscale y conn25 siguen fuera del parche
La versión 1.104.4 corrige el cliente. headscale, el servidor de control de código abierto que muchas organizaciones alojan por su cuenta, es un proyecto independiente, y el informe mantiene abiertos sus hallazgos de agotamiento de memoria. Windisch avisa de que en headscale 0.29.5 el reenvío SSH se concede en cada sesión aceptada y no se puede desactivar desde la política, así que recomienda tratar cada permiso SSH como equivalente a root hasta que haya corrección. Para un headscale accesible desde internet propone limitar la memoria del proceso, supervisar los reinicios y poner delante un proxy que limite la tasa de registros.
El hallazgo de conn25, la nueva generación de conectores de aplicación, permitía a un usuario con permiso sobre el conector elegir destinos que la política nunca había autorizado, incluido el servicio de metadatos de la nube y, en Kubernetes, cualquier servicio del clúster. Tailscale afirma que conn25 sigue en preproducción, que no se ha publicado y que los conectores estables no están afectados. Si lo pruebas en contenedores, nuestra guía de seguridad en Kubernetes explica por qué un tráfico de salida sin restricciones dentro del clúster abre tantas puertas.
La matriz de mitigación del informe, actualizada el 28 de octubre, marca conn25 como corregido a medias, con la petición de cambios 22003 todavía abierta, y deja sin corrección la comprobación de Funnel en el demonio, que Tailscale considera un comportamiento previsto.
No hay comentarios todavía